直近話題のJev、キャッチアップしたい方多いのではないでしょうか。
今回はそんなJevについて、今までの生成AIと何が違うのかを紹介します。
Jevは「判断部分」を切り出すAI
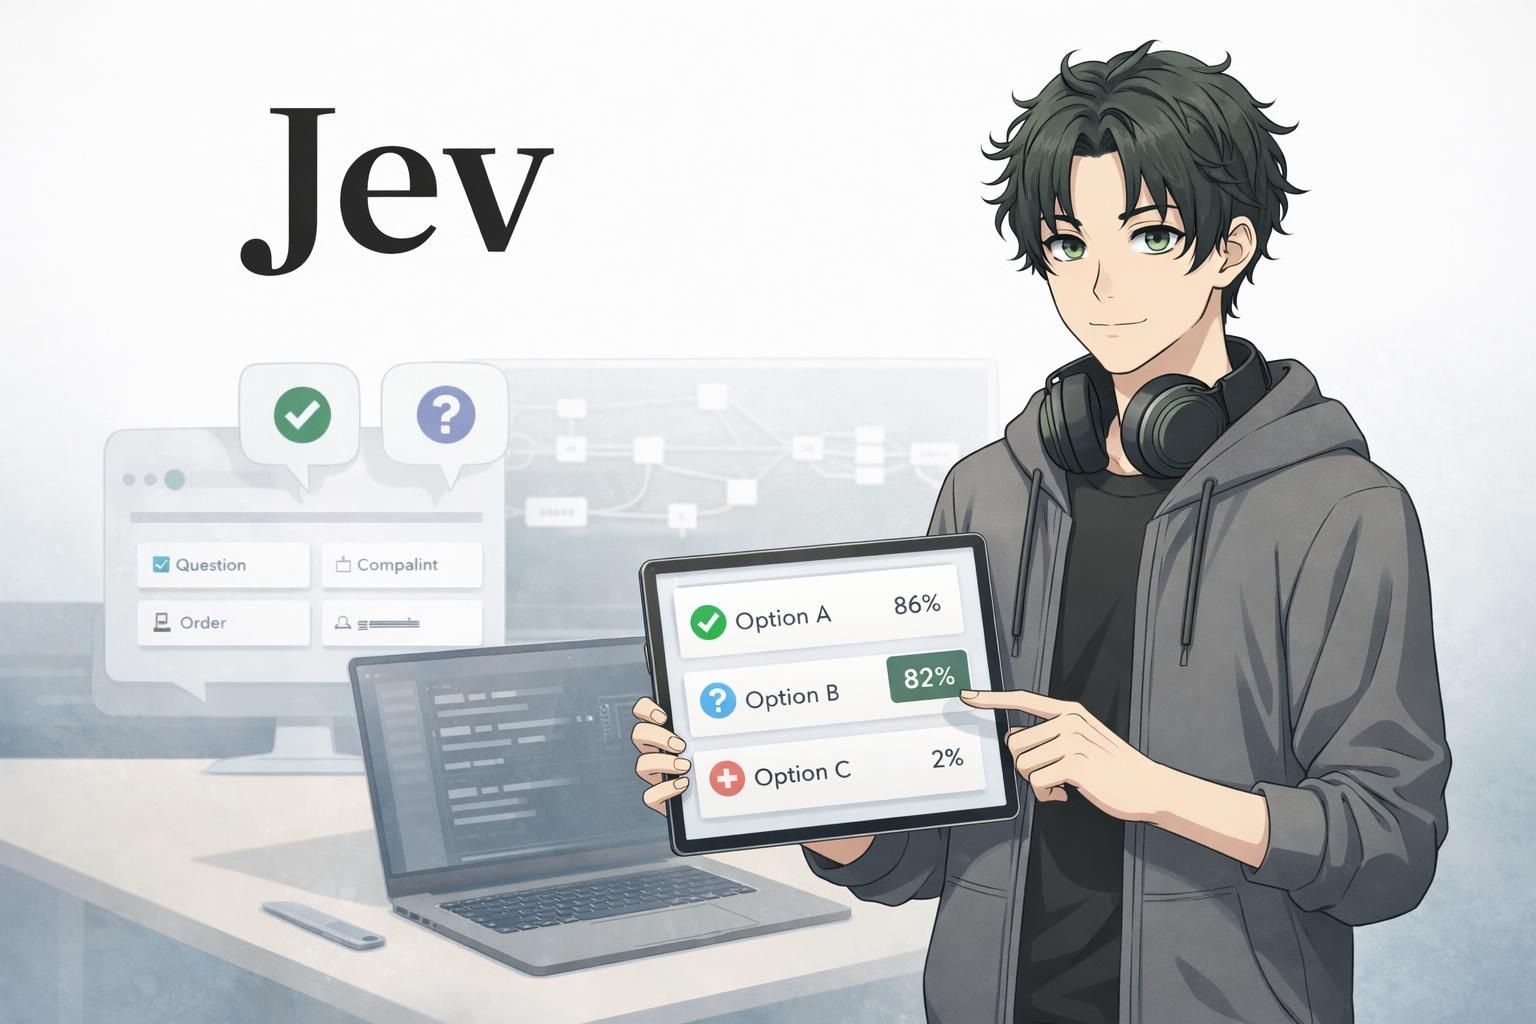
Jevは、問い合わせのカテゴリや次に使うツールを、選択肢・スコア・真偽判定として返します。人が読む説明文ではなく、プログラムが次の処理を選ぶための結果です。
たとえば「決済できない」という問い合わせでは、長い説明より先に「請求・決済へ回す」と決める必要があります。Jevはこうした小さな判断を、プログラムの次の分岐にそのまま渡せる形で返します。
JevはTypeSafe AIが2026年9月15日に発表した「System Oneモデル」です。難しい名前ですが、まずは「文章を書く前に、次の行き先を決めるAI」と考えれば十分です。
「文章を作るAI」ではなく「判断を返すAI」
Jevは、入力された状態に対して型付きの質問を投げ、コードが扱える構造化された結果を返します。長文の回答を作らない代わりに、選択肢やスコアを扱う仕事に絞っています。
たとえば、次の問い合わせを考えます。
> 昨日からクレジットカードで決済できません
普通の生成AIなら、「請求・決済に関する問い合わせです」のような説明文を返すでしょう。Jevでは、あらかじめ質問の型を決めます。
質問: この問い合わせのカテゴリは?

選択肢: 営業 / 請求・決済 / 技術サポート / その他
すると、コードが使いやすい選択結果、確率、confidence(判断の確からしさ)が返ります。TypeSafeの公式ドキュメントでは、主な質問の型を次の3つに分けています。
| 型 | 何を聞くか | 返るもの |
|---|---|---|
Choice | 選択肢からどれを選ぶか | 選択結果・確率・confidence |
Score | 基準に照らして何点か | スコア・確率・confidence |
Noul | その文がどれくらい真か | 0〜1の値 |
複数の質問を1回の呼び出しに含めることもできます。公式説明では、同じ入力状態に対して質問を並列・独立に評価します。

「幻覚しない」は「判断を間違えない」ではない
TypeSafeは、Jevが文字列生成をしないため、生成された文章のような幻覚や型エラーが起きないと説明しています。これは返り値の形式が壊れにくいという意味であり、入力に対する判断内容が必ず正しいという意味ではありません。
たとえば「請求」と返るべき問い合わせを「サポート」と判定する可能性は、別に評価しなければなりません。confidenceを見て人に回す、複数の質問に分解する、失敗時の経路を用意する。導入時に必要なのは、モデルの宣伝文句ではなく周辺の設計です。
何が新しいのか - 生成後にパースするのではなく、最初から判断用に作られている
Jevの新しさは、JSONを返せることだけではありません。生成AIに形式を守らせるのではなく、最初からソフトウェアが使う型付きの判断を返すモデルとして設計されている点にあります。
GPTのような汎用LLMでも、分類や判定はできます。OpenAIのStructured Outputsを使えば、JSON Schemaに沿った出力を要求することも可能です。
ただし、両者の出発点は違います。
汎用LLM

入力 → 文章を生成 → JSONをパース → プログラムで利用


Jev

入力 → 型付きの判断を返す → プログラムで利用
この違いは、分類のデモだけでは分かりにくいところです。判断を何千回、何万回と繰り返すシステムでは、出力の形式を毎回解析する処理や、文章が形式から外れた場合のエラー処理も設計対象になります。
Jevはその仕事を小さくし、Choice や Score の結果をコードの分岐に接続しやすくしています。逆に、文章の説明、コードの生成、複雑な推論をJevに任せるモデルではありません。
料金と速さは魅力。ただし「安いから置き換える」とは考えない
Jevは入力単価と出力形式を絞ることで安く見えますが、価格だけで汎用LLMとの優劣を決めるものではありません。料金は確認日と提供経路を添えて見る必要があります。
TypeSafe AI公式の発表では、Jevは入力100万トークンあたり0.042ドル、出力は無料と案内されています。一方、Vercel AI GatewayのJevページでは、確認時点で入力0.04ドル/100万トークンの表示があり、無料のプロモーション表示もありました。丸め、経路、キャンペーンの違いを含む可能性があるため、同じ価格として断定しない方が安全です。
比較対象として、OpenAI公式のGPT-5.6 Lunaは、入力0.20ドル、出力1.20ドル/100万トークンです。Lunaはコスト重視・高ボリューム向けの汎用モデルなので、Jevと同じ仕事をするモデルではありません。
| 100万トークンあたり | Jev | GPT-5.6 Luna |
|---|---|---|
| 入力 | $0.042(TypeSafe公式) | $0.20 |
| 出力 | 無料(TypeSafe公式) | $1.20 |
| 返すもの | 型付きの判断 | 文章・構造化出力など |
速さは「並列評価」という設計から生まれる
通常の生成AIは、前に生成したトークンをもとに次のトークンを順番に作ります。Jevは文字列を生成せず、複数の判断を並列に評価する設計です。
そのため、TypeSafeはJevをソフトウェア内のリアルタイムな判断に向くモデルとして説明しています。ただし、ここで注意したいのは、公式の設計説明と、読者の環境での実測は別だということです。
ネットワーク、入力サイズ、呼び出し回数、同時実行数で体感は変わります。今回の記事では、JevがGPTより何倍速い、という第三者ベンチマークの数値は採用していません。導入するなら、代表的な入力を用意して自分の構成で測る必要があります。
GPTのStructured OutputsとJevはどう使い分ける?
Structured Outputsは汎用LLMの出力形式を整える機能で、Jevは判断そのものを主役にしたモデルです。どちらが上ではなく、生成が必要か、判断だけでよいかで選びます。
| やりたいこと | 向く選択肢 | 理由 |
|---|---|---|
| 問い合わせのカテゴリだけ決める | Jev | 選択結果を分岐に使いやすい |
| カテゴリを決め、その理由も文章で説明する | 汎用LLM | 生成と判断を一度に扱いやすい |
| 資料から会社名や住所を抜き出す | 汎用LLM | 抽出と整形の自由度が必要 |
| 決められた基準で採点する | Jev | Score と確率を扱える |
| 複数条件を整理して結論を説明する | 汎用LLM | 長い推論と文章化が必要 |
status == "failed" を分岐する | 通常のプログラム | AIを使わずに確定できる |
Jevを使う目安は、次の3つです。
1. 普通のif文だけでは判断しづらい。
2. 返してほしい答えの型や選択肢は決まっている。
3. その判断が大量、または繰り返し発生する。
逆に、1回きりの分類や、分類結果を人が読むだけの処理なら、既存の汎用LLMで十分なこともあります。新しいモデルを追加するコストも含めて判断してください。
Jevは実際にどこで使える?
Jevが活きるのは、生成の前後にある「次の処理を決める部分」です。判断の結果を業務フローへつなげると、単なる分類デモから一歩進んだ使い方になります。
問い合わせやメールを振り分ける
問い合わせを営業、請求、サポートなどへ分け、その結果を担当チームや処理キューへ渡します。Jevの公式用途にあるclassificationやroutingに近い使い方です。
生成AIに渡す情報を先に絞る
大量の文書やログから、今回の依頼に関係するものだけを選び、必要な部分を汎用LLMへ渡す構成です。Jevが前段のフィルターになれば、生成AIに送る入力を減らせる可能性があります。
ただし、関係ないと判定した情報の中に重要な例外がないかは別途確認が必要です。「Jevを通せば必ずトークン料金が下がる」とは限りません。
生成した回答をチェックする
回答が質問に答えているか、必要な項目が含まれているか、人の確認が必要かをスコアや真偽判定で確認します。生成するAIとチェックするAIを分ける考え方です。
ここでも、confidenceの閾値は業務ごとに決める必要があります。95%なら自動処理、70%未満なら人手、といった数字は説明用の例であり、TypeSafe公式の推奨値ではありません。
AIエージェントでは「次に何を使うか」を判断させる
AIエージェントの処理は、検索するか、データベースを見るか、コードを実行するか、回答を作るかという小さな判断の連続です。Jevを前段のルーターに置くと、判断と生成・実行を分けて設計できます。
ユーザーの依頼

      ↓

Jevが次の処理を選ぶ

      ├─ Web検索

      ├─ データベース

      ├─ コード実行

      └─ 汎用LLMで説明・推論
この構成の目的は、GPTをなくすことではありません。GPTに文章化や複雑な推論を集中させ、単純な振り分けを別の判断部品に出すことです。
ただし、エージェントのルーティングは失敗すると後続の処理全体を誤ります。confidenceを使って保留にする、人の確認へ回す、ログを保存して評価する、といった安全弁を最初から含めてください。
まとめ:Jevは「小さな判断」をソフトウェアに組み込むための選択肢
Jevは、GPTより何でもできる万能AIではありません。文章生成を手放し、Choice、Score、Noul のような型付きの判断と、確率・confidenceを返すことに集中したモデルです。
見るべきポイントは、単価の安さだけではありません。
- if文だけでは決めにくいが、答えの型は決まっているか
- 同じ判断を大量・反復的に実行するか
- confidenceが低いときの保留・人手確認を設計できるか
この条件がそろうなら、問い合わせ分類やAIエージェントのルーティングで試す価値があります。逆に、説明文やコードを作る仕事なら、汎用LLMの方が自然です。
「AIに全部やらせる」ではなく、生成するAIと判断するAIを分ける。Jevが面白いのは、新しいモデルが出たからというより、AIをソフトウェアの部品として設計し直すきっかけを示しているからです。
参考リンク
仕様・料金・比較対象の確認に使った公式ページです。